单卡 5 天训出机器鸭 14 个技能:队列化 RL 训练实践
项目概况
MicroDuck 是一只双足机器鸭:15 个 XL330 舵机、Radxa ZERO 3W 主控、50Hz 控制频率。这次的目标是给它训练一整套多技能策略库——行走、滑行、起身、翻滚、踢球、拾取、坐立……最终 14/14 全部训完,每个技能导出 ONNX 部署。
技术栈:
- 仿真:mjlab(MuJoCo Warp 后端,GPU 并行物理)
- 算法:PPO(rsl_rl),Flat 地形 4096 envs,Rough 地形降到 2048 envs
- 硬件:单张 GPU,串行任务队列,总耗时约 5 天
技能矩阵与结果
| 技能 | Flat | Rough | 迭代数 |
|---|---|---|---|
| Velocity(行走) | ✅ | ✅ | 25k |
| Velocity-Rollers(滑行) | ✅ | — | 25k |
| Velocity-Swizzle(摆步) | ✅ | — | 25k |
| VelStand(行走+恢复) | ✅ | ✅ | 10k |
| StandUp(起身) | ✅ | ✅ | 7.5k |
| GroundPick(拾取) | ✅ | ✅ | 10k |
| BallKick(踢球) | ✅ | — | 5k |
| Roulade(翻滚) | ✅ | — | 7.5k |
| SitStand(坐立) | ✅ | ✅ | 7.5k |
全部技能一图流(12 宫格合成):
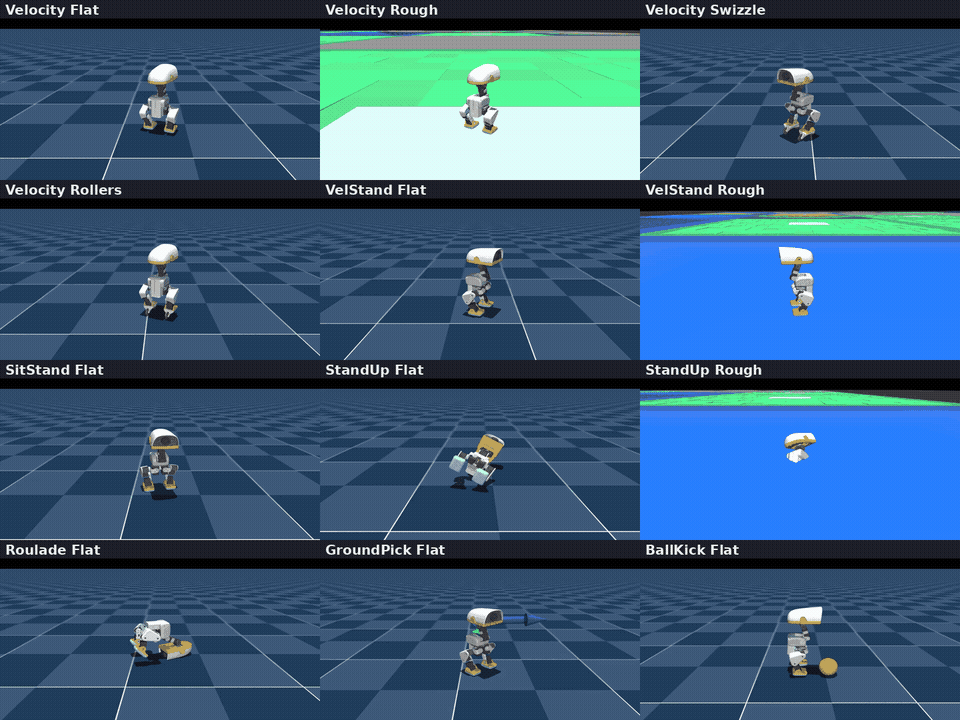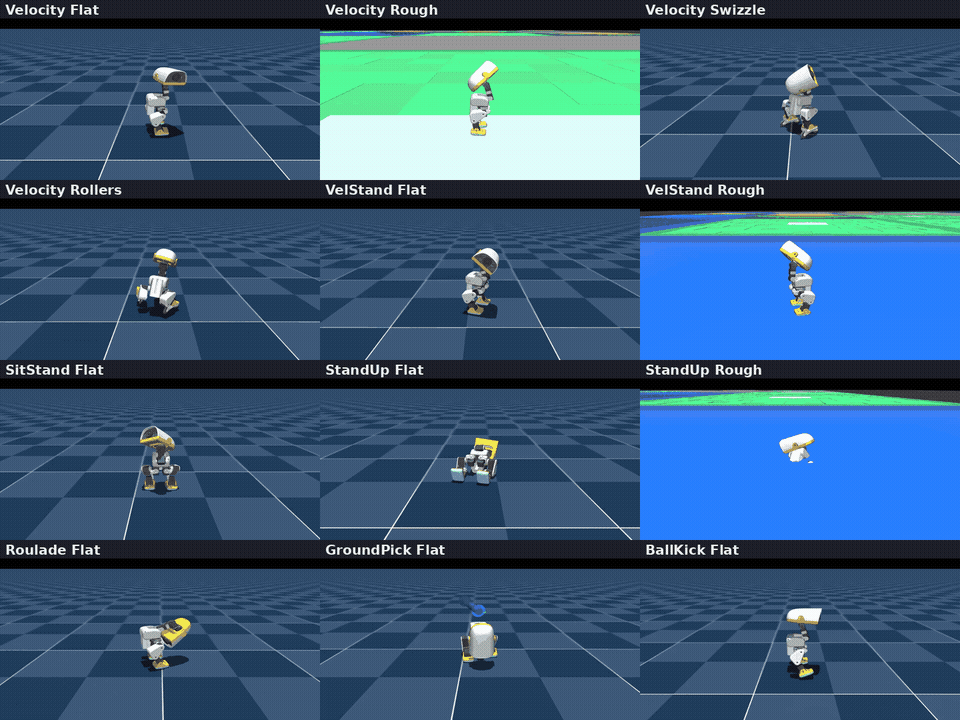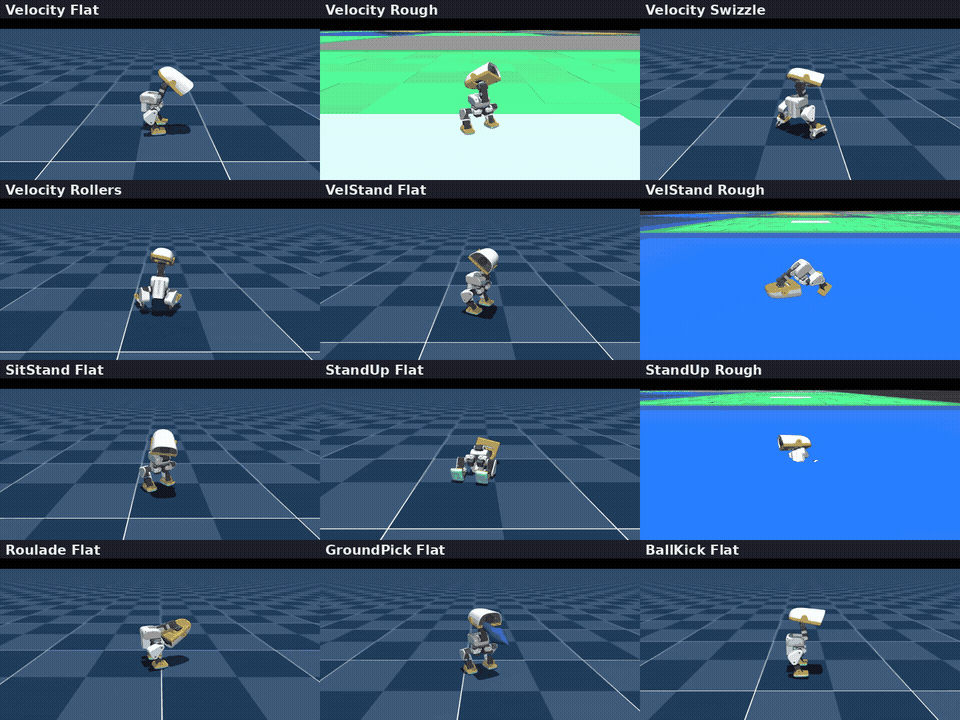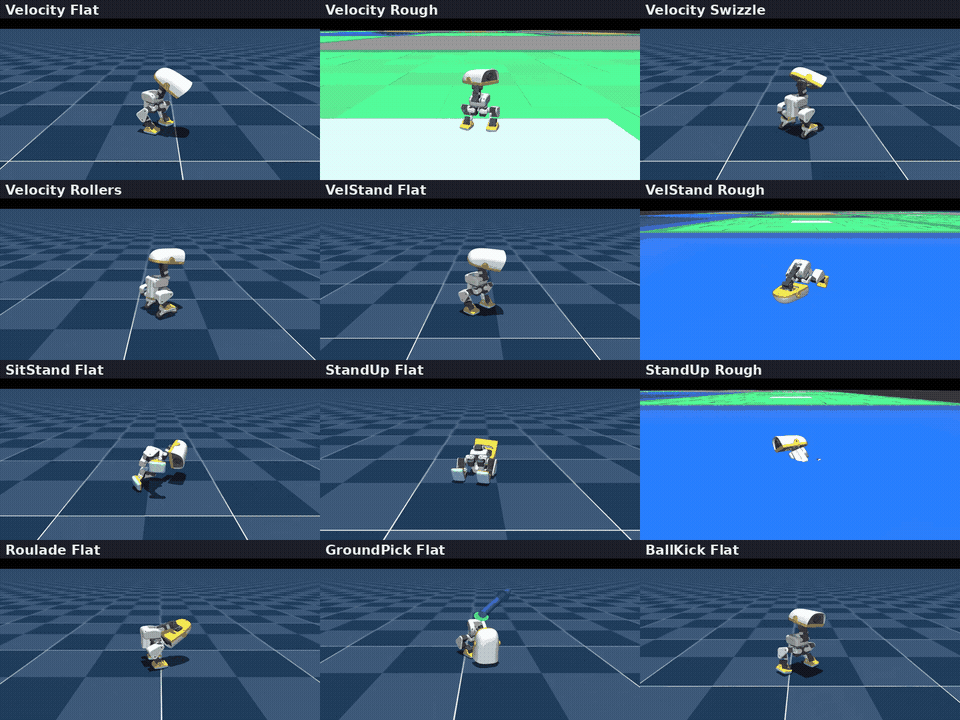
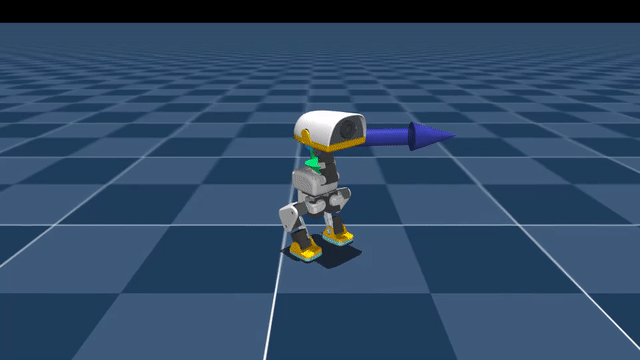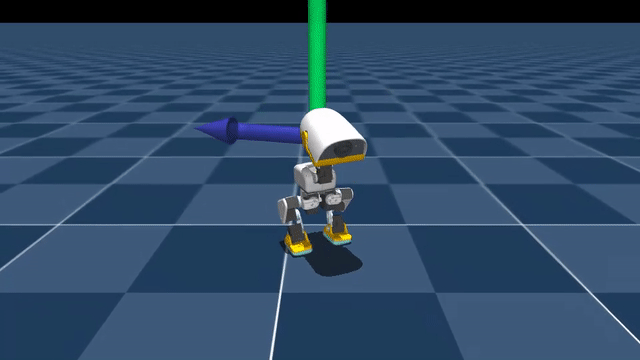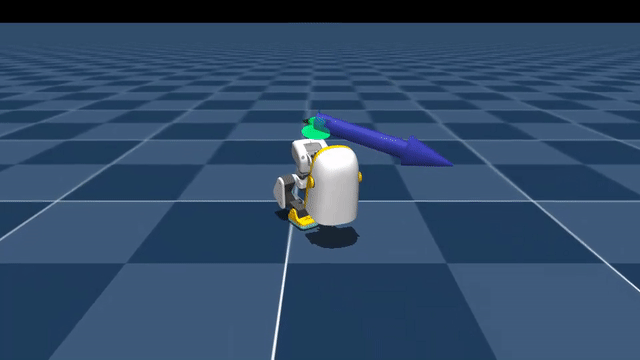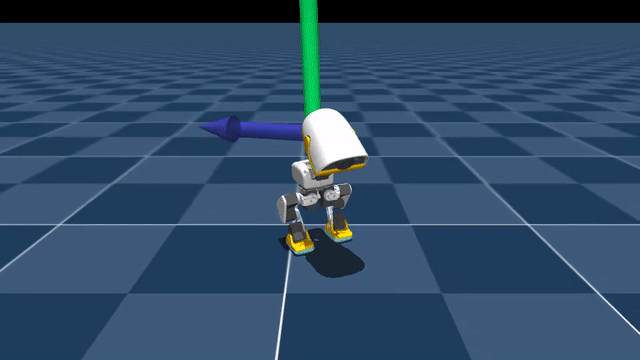
训练成功评估:全部技能回放 GIF
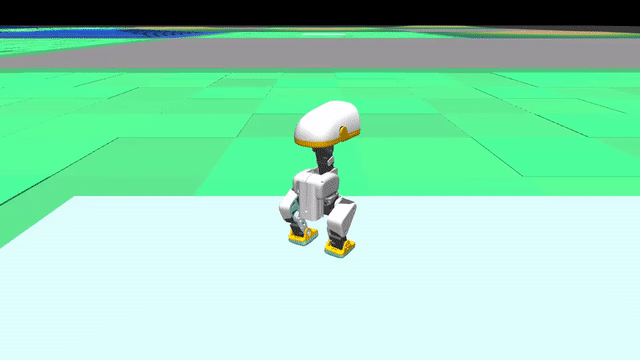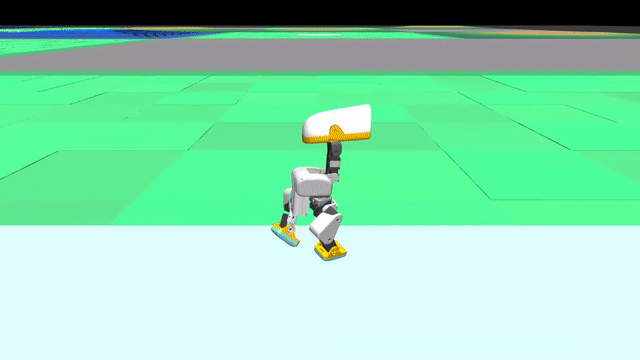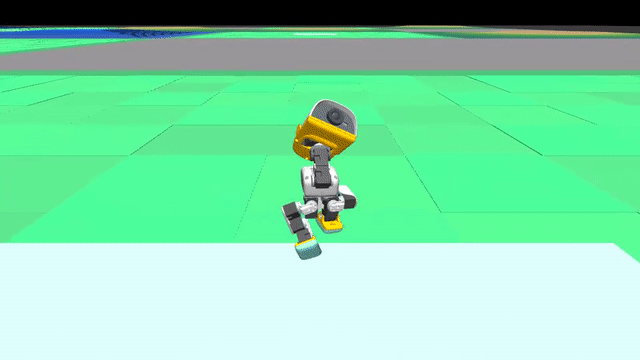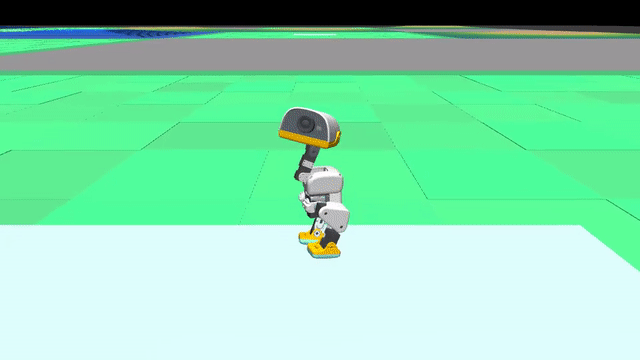
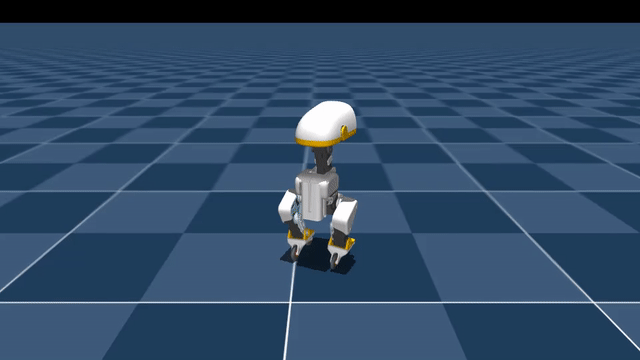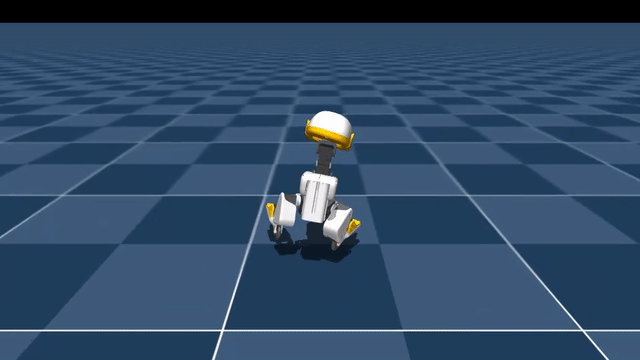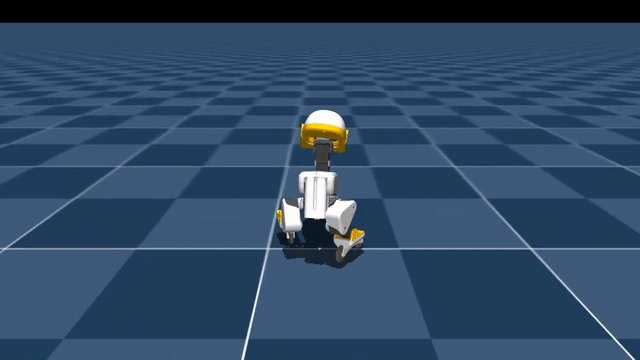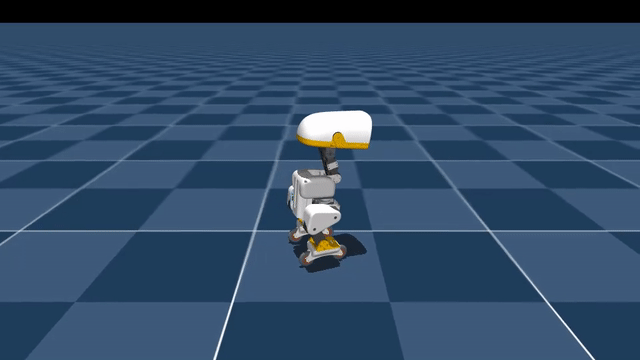
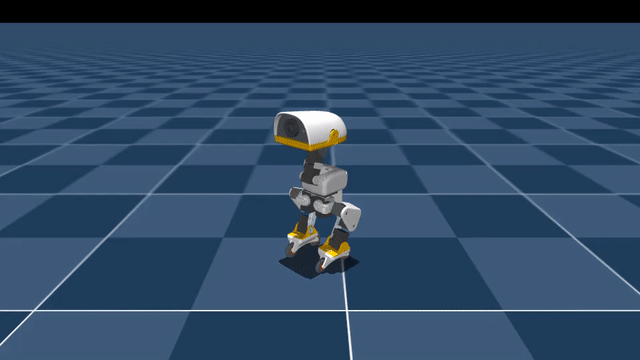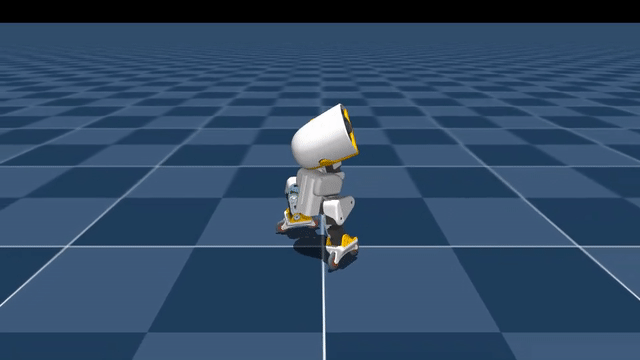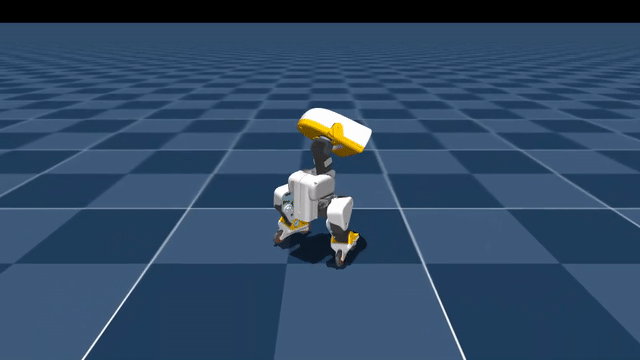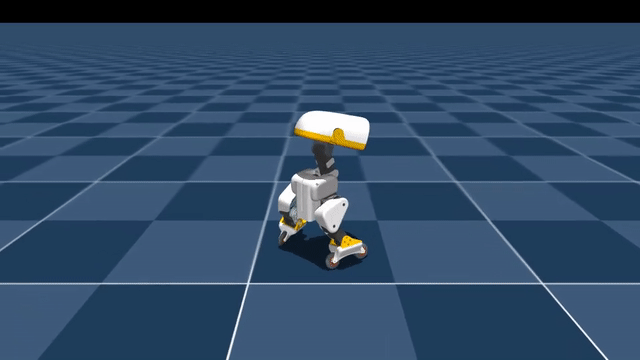
Loss 曲线好看不等于步态好看——回放 GIF 才是最好的验收方式。以下是 14 个技能的单 env 回放(每个 300 帧,ffmpeg palettegen/paletteuse 转制)。
行走系
Velocity-Flat(标准行走):
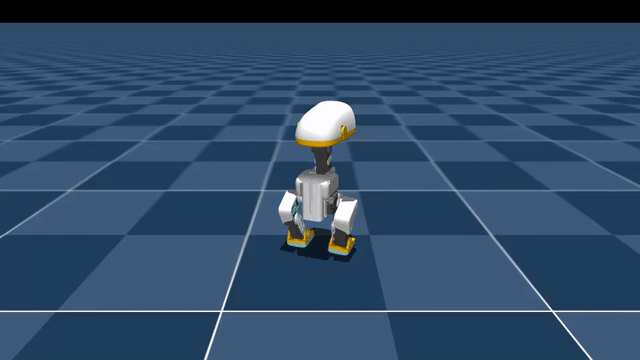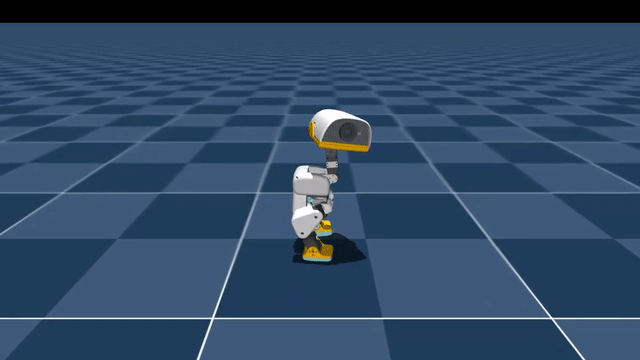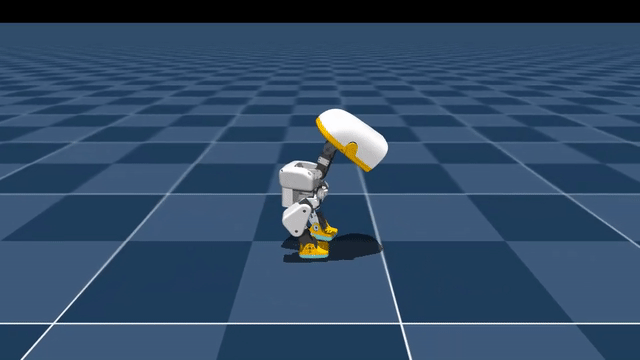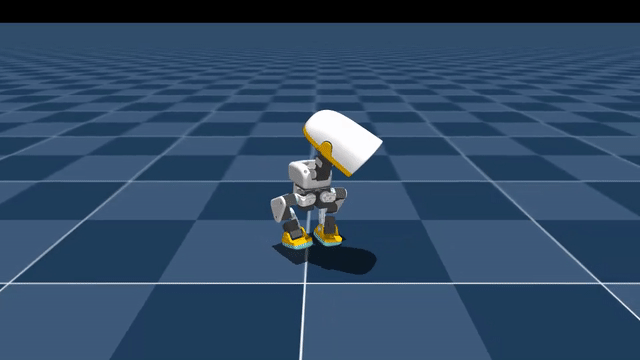
Velocity-Rough(粗糙地形行走,OOM 降配 2048 envs 后通过):
Velocity-Rollers(脚装滑轮的滑行步态):
Velocity-Swizzle(摆步):
恢复系
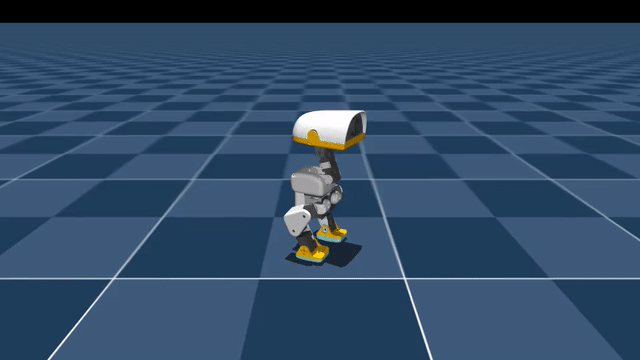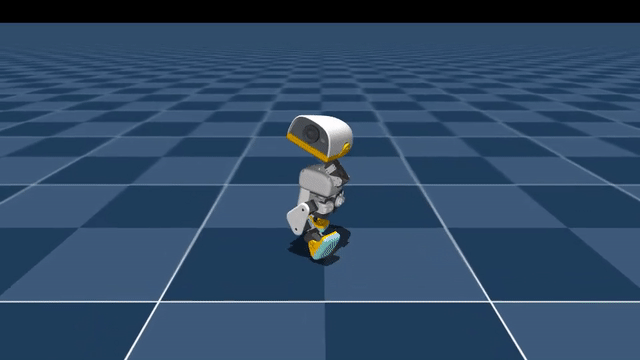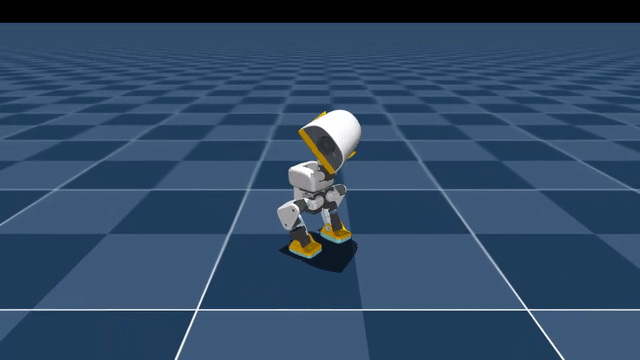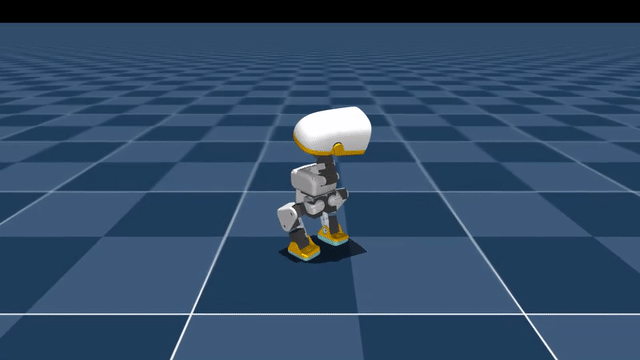
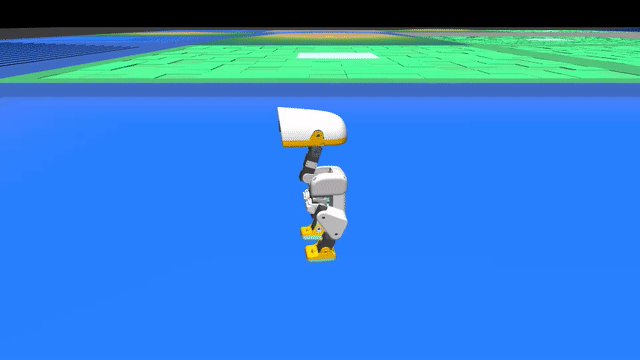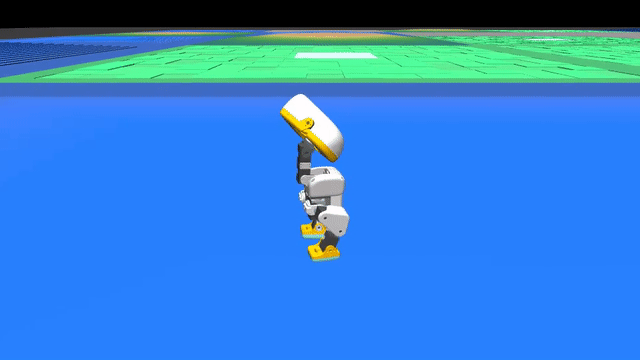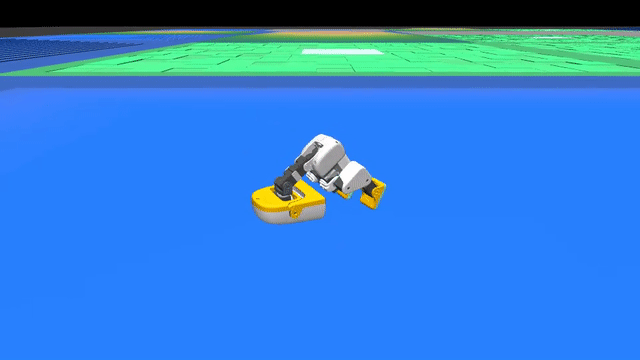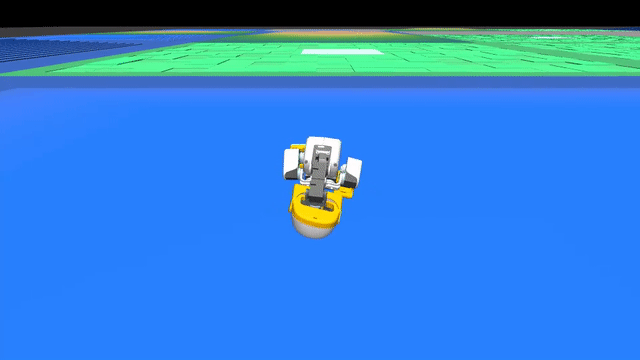
VelStand-Flat(行走 + 摔倒恢复合一):
VelStand-Rough:
StandUp-Flat(从坐姿起身,一次通过):
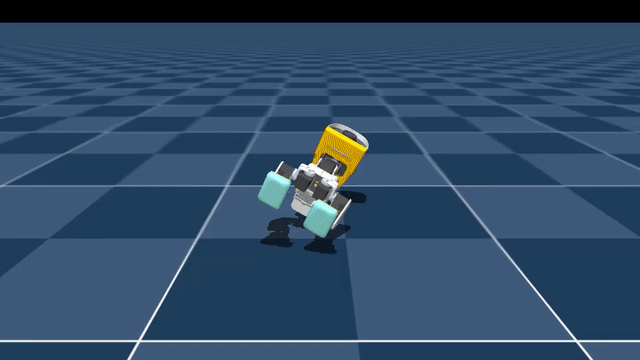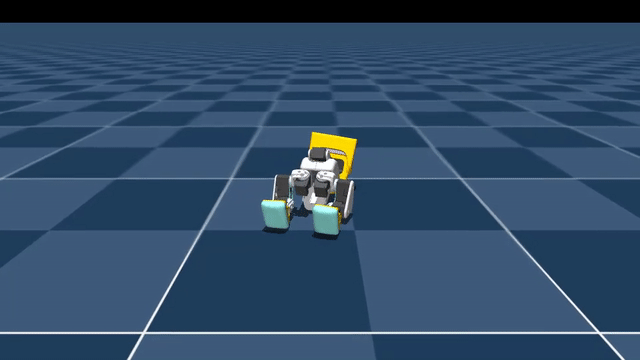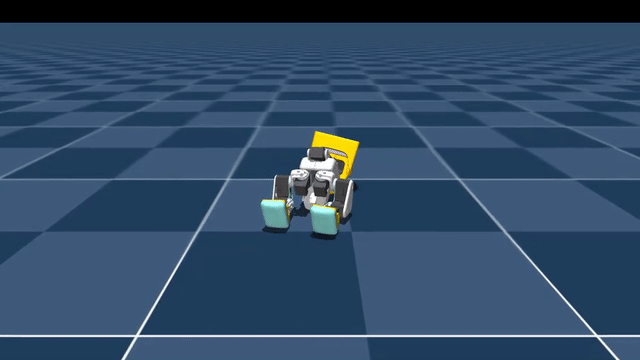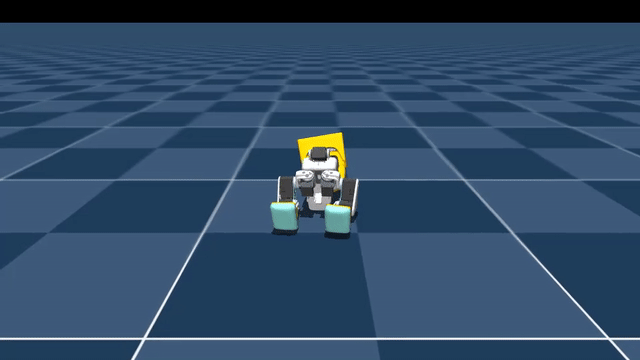
StandUp-Rough:
技巧系
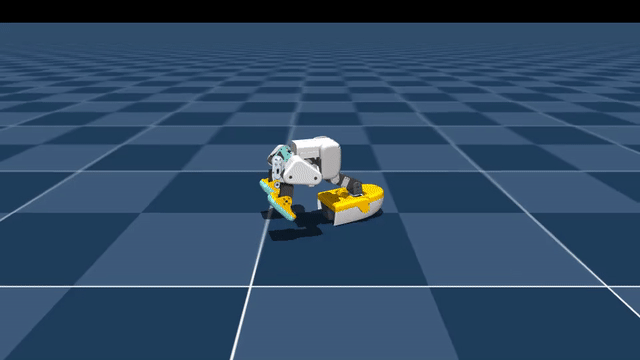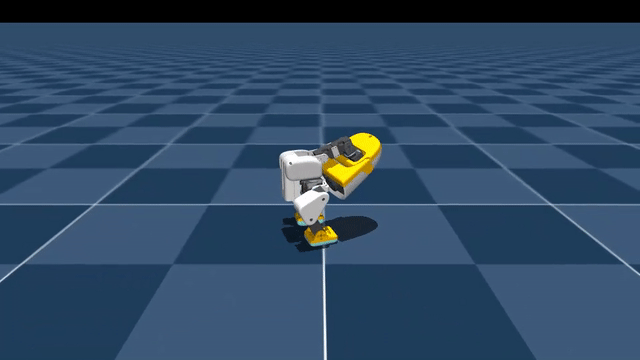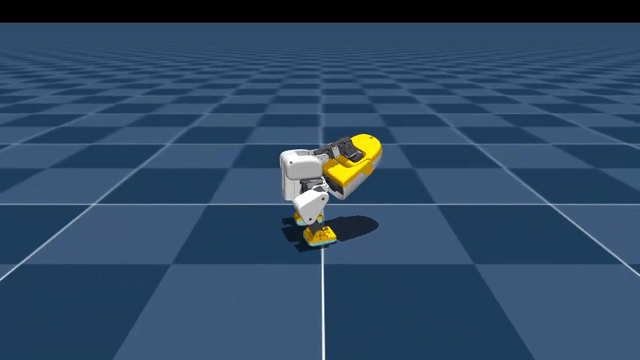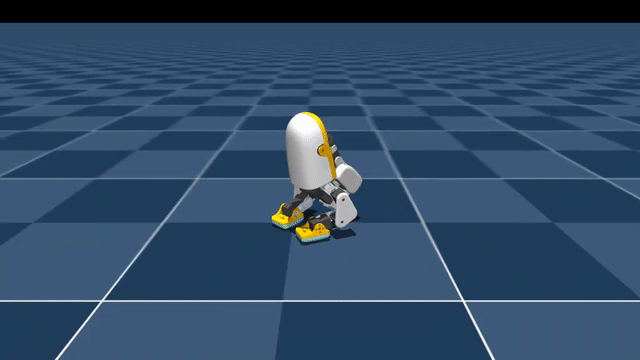
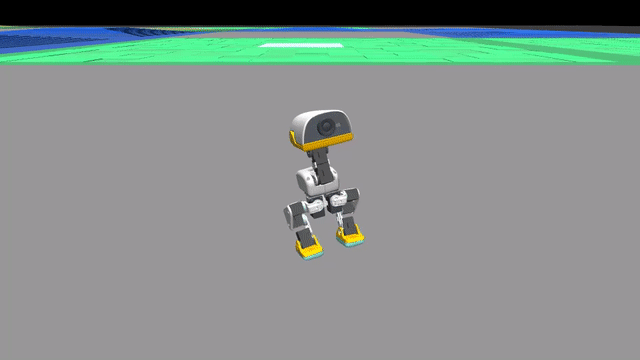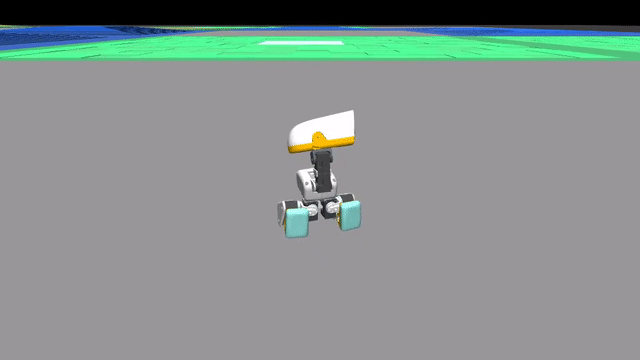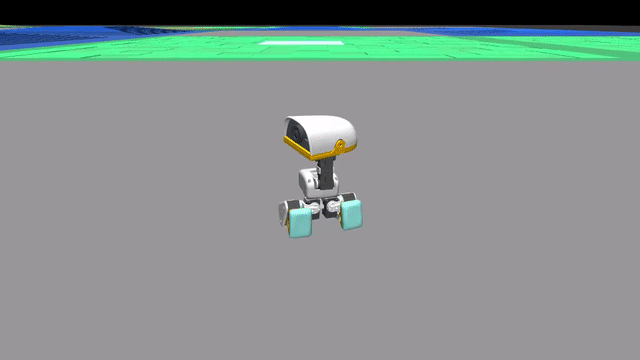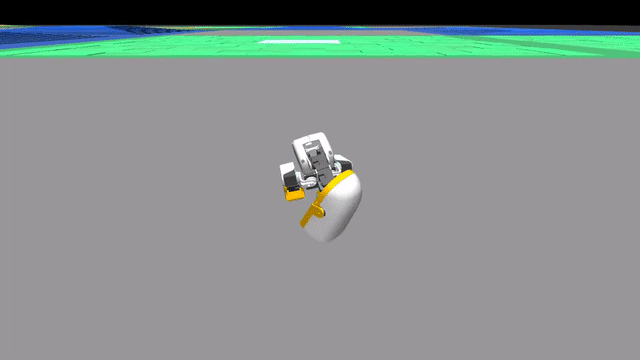
Roulade(翻滚,run-2 重写 reward 后的”教科书级”版本):
SitStand-Flat(坐↔立切换,posture-conditioned 动目标):
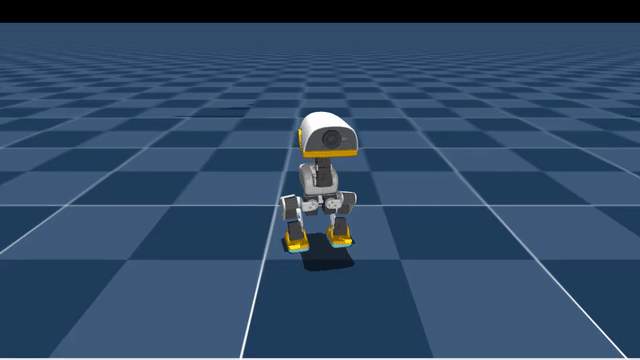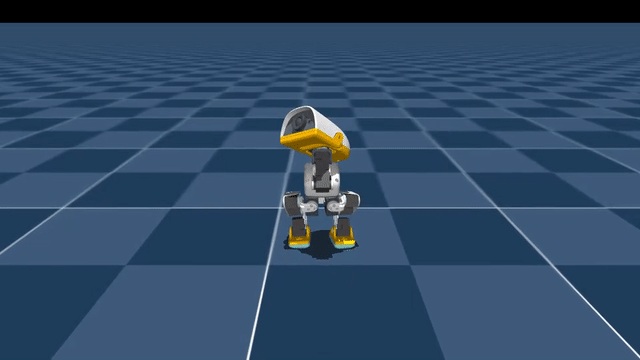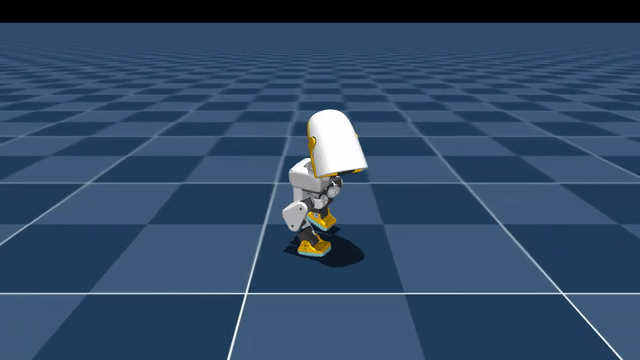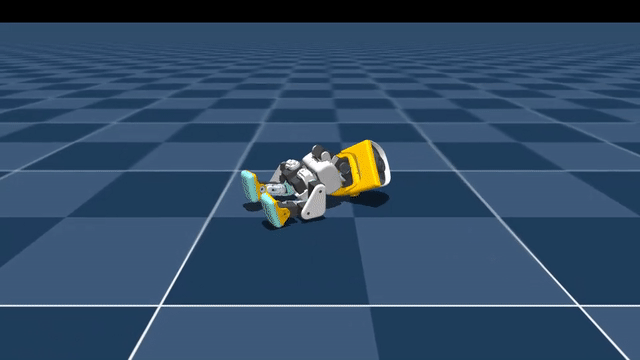
SitStand-Rough(NaN-safe patch 补训通过):
任务系
BallKick-Flat(盲踢——actor 看不见球,critic 看得见):
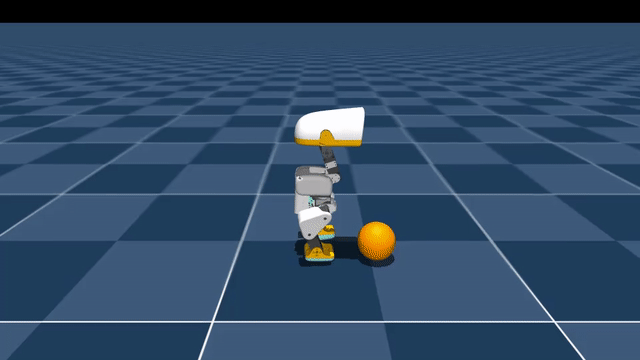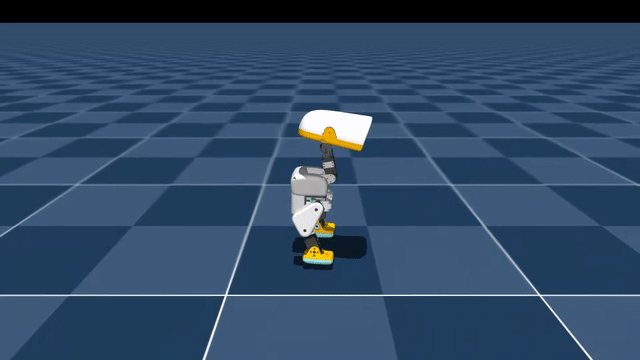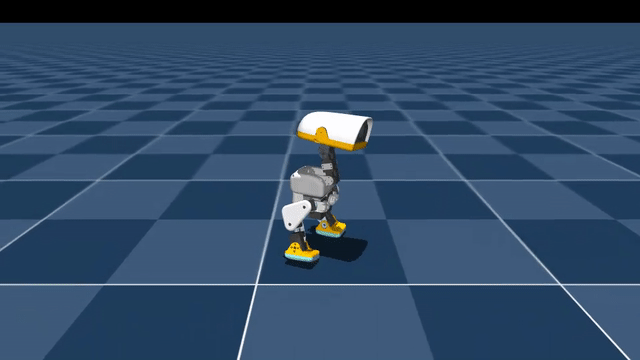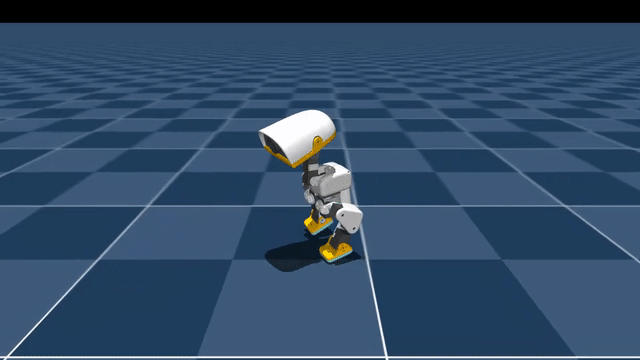
GroundPick-Flat(拾取,任务空间定义代替姿态工程):
工程侧:单卡长训的三板斧
1. 串行队列 + .done 标记
用 bash 关联数组定义任务清单,逐个串行跑,避免 GPU 抢占。任务完成打 .done 标记文件,失败(rc≠0)不标记,留给补训队列。单卡无人值守长训的最简可靠方案。
2. OOM 降配重试
第一轮 rough 地形任务大面积秒挂——根因是 rough 地形在 4096 envs 下爆显存。对策很直接:rough 任务统一降到 2048 envs 重跑,全部通过。
教训:地形复杂度↑ → 观测/物理状态显存↑,envs 数要预留余量。经验起点:rough 任务 envs 打七折。
3. OOM 和 NaN 是两类故障
- OOM:几十秒内 rc=1 退出,看日志尾部即可确诊
- NaN:训练几分钟到几小时后死于
ValueError: The observation group 'critic' contains NaN values,要看 wandb 曲线定位发散源头
NaN 的通用修复是一个 NaN-safe patch:reward/advantage 加 NaN 保护 + nan_state 终止检测(wandb 监控 Episode_Termination/nan_state)。SitStand-Rough 和 GroundPick-Rough 都靠它通过。
Reward 设计:每个任务都是一次经济学设计
这是整个项目最有意思的部分——14 个技能背后是 9 套完全不同的 reward 设计哲学。
通用原则
- task reward 质量 ≈ 10,让共享正则项在不同任务间作用于相同相对强度
- DR/噪声/正则配方以 velocity 为基准,各任务只叠加任务层——迁移已验证的配方,不重造
- 目标项给梯度、正则项只收税:大动作任务中,运动阻碍项(body_ang_vel、冲击惩罚)探索期压到近零,靠 curriculum 后期引入——taxing attempts 会直接杀死发现
- potential-based 进度奖励:只对”最远进展”付增量,停在原地零收益,天然防 reward farming
几个精彩的案例
Velocity:upright 刻意加狠。 weight 1.0 时 4° 前倾每步只罚 ~0.05,等于免费——结果稳态步态前倾 2-4°、2/3 被推倒向前。收紧到 weight 2.0 后仍留裕度吸收瞬态前倾。另外原地转身专门分桶:15% envs 采 lin=0 + |ang|∈[0.4,1.0](独立均匀采样下 spin-on-the-spot 仅 ~2% 数据,学不会)。
StandUp:逃逸盆地设计。 height 三层结构:dense(宽梯度拉全程)+ sharp(最后一厘米 0.36→1.0 跳变补拉力)+ L1(打破静态盆地:坐着不动是净负)。而 mid-roll spawn 反向 curriculum 是解锁仰面恢复的关键——从翻转中段开局,把不可学的整体问题切成已知可学的半段。
Roulade:run-1 学出了暴力弹射 breakdance。 奖励”累计 2π 越快越好”+ 无接触约束,策略在旧奖励下确实最优。run-2 对策:支撑门控(仅触地旋转计入累计器)+ 落地奖励门控滚转前沿 ≥260° + 进度付率封顶 3 rad/s + 超速罚。风格才是稀缺品。
BallKick:非对称 actor-critic。 实机无球感知(操作者瞄准),所以 actor 对球盲,鲁棒性来自 ±2cm 落球域随机化;但 critic 看得见球——value 预支踢球收益,帮 actor 学得更快。
GroundPick:不定义 DOWN 姿态。 用”嘴贴近地面 + 禁止接触 + 垂直朝向”三力平衡让嘴悬停贴地——任务空间定义代替姿态工程。
VelStand:三次审计迭代。 恢复层门控在”确实摔倒”(干净行走时贡献恰为零);统一”恢复完成”定义(tilt<25° 且 z>0.09,可达);最后一英里用 potential-based Δz 补进度。每一轮都在跟 reward 经济学的漏洞搏斗。
PPO 参数速查
| 参数 | 值 |
|---|---|
| 网络 | MLP 512-256-128, ELU(actor/critic 对称) |
| learning_rate | 1e-3, adaptive(desired_kl=0.01 锚定) |
| gamma / lam | 0.99 / 0.95 |
| clip_param | 0.2 |
| num_steps_per_env | 24 |
| epochs / mini_batches | 5 / 4 |
| envs | Flat 4096 / Rough 2048 |
| max_iterations | 按任务 5k~25k |
核心稳定器是 adaptive LR + desired_kl=0.01。无 RNN、无 CNN,纯 MLP + obs normalization,对 50Hz 舵机控制完全够用。
核心教训
- 队列 + .done 标记 + 降配重试是单卡长训的最简可靠方案,全程无人值守
- OOM 与 NaN 是两类故障:OOM 秒挂看日志尾部;NaN 早夭要看 wandb 曲线定位发散源头
- 回放 GIF 是最好的验收方式——loss 曲线好看不等于步态好看
- 显存预算:rough 地形任务 envs 打七折是经验起点
- Reward 设计是经济学:每一项奖励都要问”这条税会不会杀死你想要鼓励的探索”
训练代码基于 pollen-robotics/microduck_rl,仿真用 mjlab(MuJoCo Warp),训练框架 rsl_rl。有问题欢迎交流 🐾
评论